数字化工厂的数据收集、处理与数据挖掘 从感知到智能决策
引言
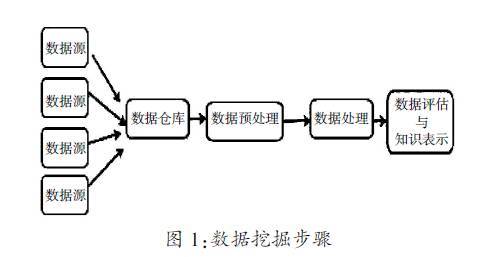
数字化工厂的核心在于将物理生产系统与数字世界深度融合,而数据是这一融合的血液。从设备运转到质量检测,从物料流动到人员操作,工厂每时每刻都在产生海量数据。如何高效地收集、处理这些数据,并通过数据挖掘提取价值,是实现智能制造的关键。本文将系统阐述数字化工厂的数据收集、处理流程以及数据挖掘的应用。
一、数据收集:构建工厂的感知神经
数字化工厂的数据收集强调“全面、实时、准确”。主要来源包括:
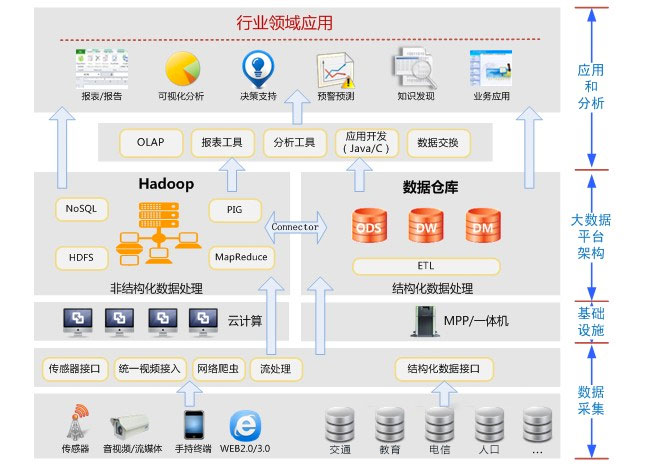
- 设备与传感器数据:通过PLC、SCADA、工业物联网(IIoT)传感器采集温度、压力、振动、电流、转速等运行参数。采用OPC UA、MQTT、Modbus等协议实现设备互联。
- 生产与过程数据:MES(制造执行系统)记录工单进度、产量、良率、工艺参数;QMS(质量管理系统)采集检测结果。
- 物料与物流数据:RFID、二维码、AGV定位系统追踪物料批次、库存、流转路径。
- 人员与环保数据:可穿戴设备、门禁系统记录人员位置与操作;环境传感器监测温湿度、能耗、排放。
- 外部数据:ERP中的订单、供应链信息,以及市场、天气等辅助数据。
收集技术:边缘计算网关就近采集并预处理;工业以太网、5G、Wi-Fi 6提供低时延传输;时序数据库(如InfluxDB)高效写入高频数据。
二、数据处理:从原始数据到可用信息
原始数据往往含有噪声、缺失、格式不一,需经过层层处理:
- 数据清洗:去除重复值、填补缺失值、平滑噪声(如滑动平均、卡尔曼滤波),剔除异常点。
- 数据集成:将来自不同系统(PLC、MES、ERP)的数据统一到数据中台或数据湖,解决语义冲突与单位不一致。
- 数据变换与归约:标准化/归一化、离散化、特征编码;通过主成分分析(PCA)降维,保留关键信息。
- 数据存储与管理:采用时序数据库存储传感器数据,关系数据库存储业务数据,数据湖(如Hadoop、Delta Lake)存储原始与半结构化数据。建立数据字典与元数据管理,确保可追溯。
- 实时流处理:利用Flink、Spark Streaming对产线数据流进行窗口聚合、模式检测,支持实时监控与报警。
三、数据挖掘:从数据中提炼智慧
数据挖掘在数字化工厂中贯穿多个层面:
3.1 描述性挖掘——理解现状
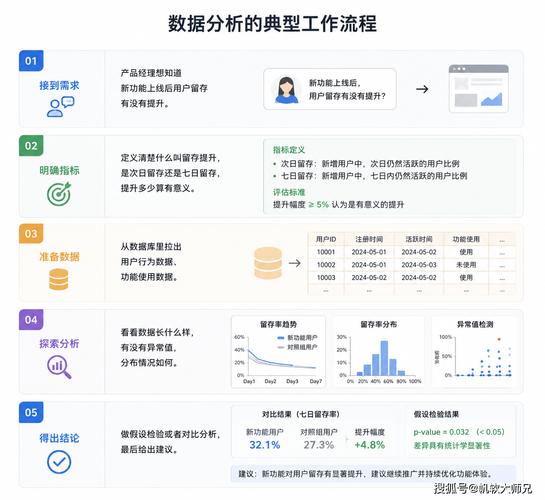
- 关联规则:发现工艺参数与缺陷的关联(如“温度>80℃且压力<0.5MPa → 次品率升高”)。
- 聚类分析:对设备工况聚类,识别不同运行模式;对产品质量分群。
- 可视化:通过Dashboard、数字孪生呈现产线状态。
3.2 预测性挖掘——预见未来
- 分类与回归:预测设备故障(随机森林、XGBoost)、预测产品质量(神经网络)。
- 时间序列预测:预测订单需求、能耗趋势(ARIMA、LSTM)。
- 异常检测:基于孤立森林、自编码器识别设备异常与质量波动。
3.3 指导性挖掘——优化决策
- 优化算法:遗传算法、强化学习用于排产调度、工艺参数寻优。
- 根因分析:结合贝叶斯网络、决策树定位缺陷根源。
- 数字孪生仿真:在虚拟环境中测试不同策略,将最优解反馈至物理产线。
典型应用场景:
- 预测性维护:减少非计划停机30%以上。
- 质量预警:提前拦截批量缺陷,降低废品率。
- 能耗优化:通过挖掘能耗模式,节能5%-15%。
四、挑战与趋势
挑战:数据孤岛、数据质量差、实时性要求高、安全与隐私、复合人才短缺。
趋势:
- 边缘智能:在设备端直接运行轻量级挖掘模型。
- 自动机器学习(AutoML):降低数据挖掘门槛。
- 联邦学习:在保护隐私的前提下跨工厂联合建模。
- 大语言模型:辅助生成数据报告、交互式查询。
##
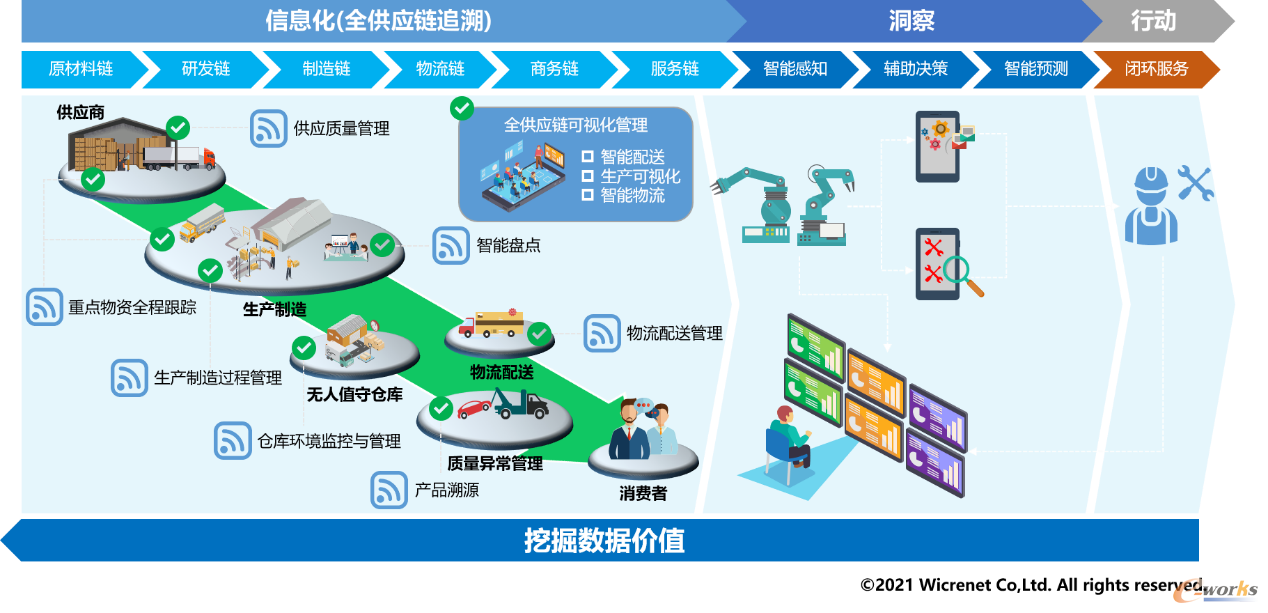
数字化工厂的数据收集、处理与挖掘是一个闭环:传感器感知物理世界,数据处理提炼信息,数据挖掘生成模型与洞察,再反馈至物理系统优化运行。只有打通这一链条,才能让数据真正成为工厂的“智慧大脑”。
(本文约1500字,涵盖技术流程与落地应用,可根据具体行业调整案例。)
如若转载,请注明出处:http://www.chengka2018.com/product/43.html
更新时间:2026-10-15 17:35:44